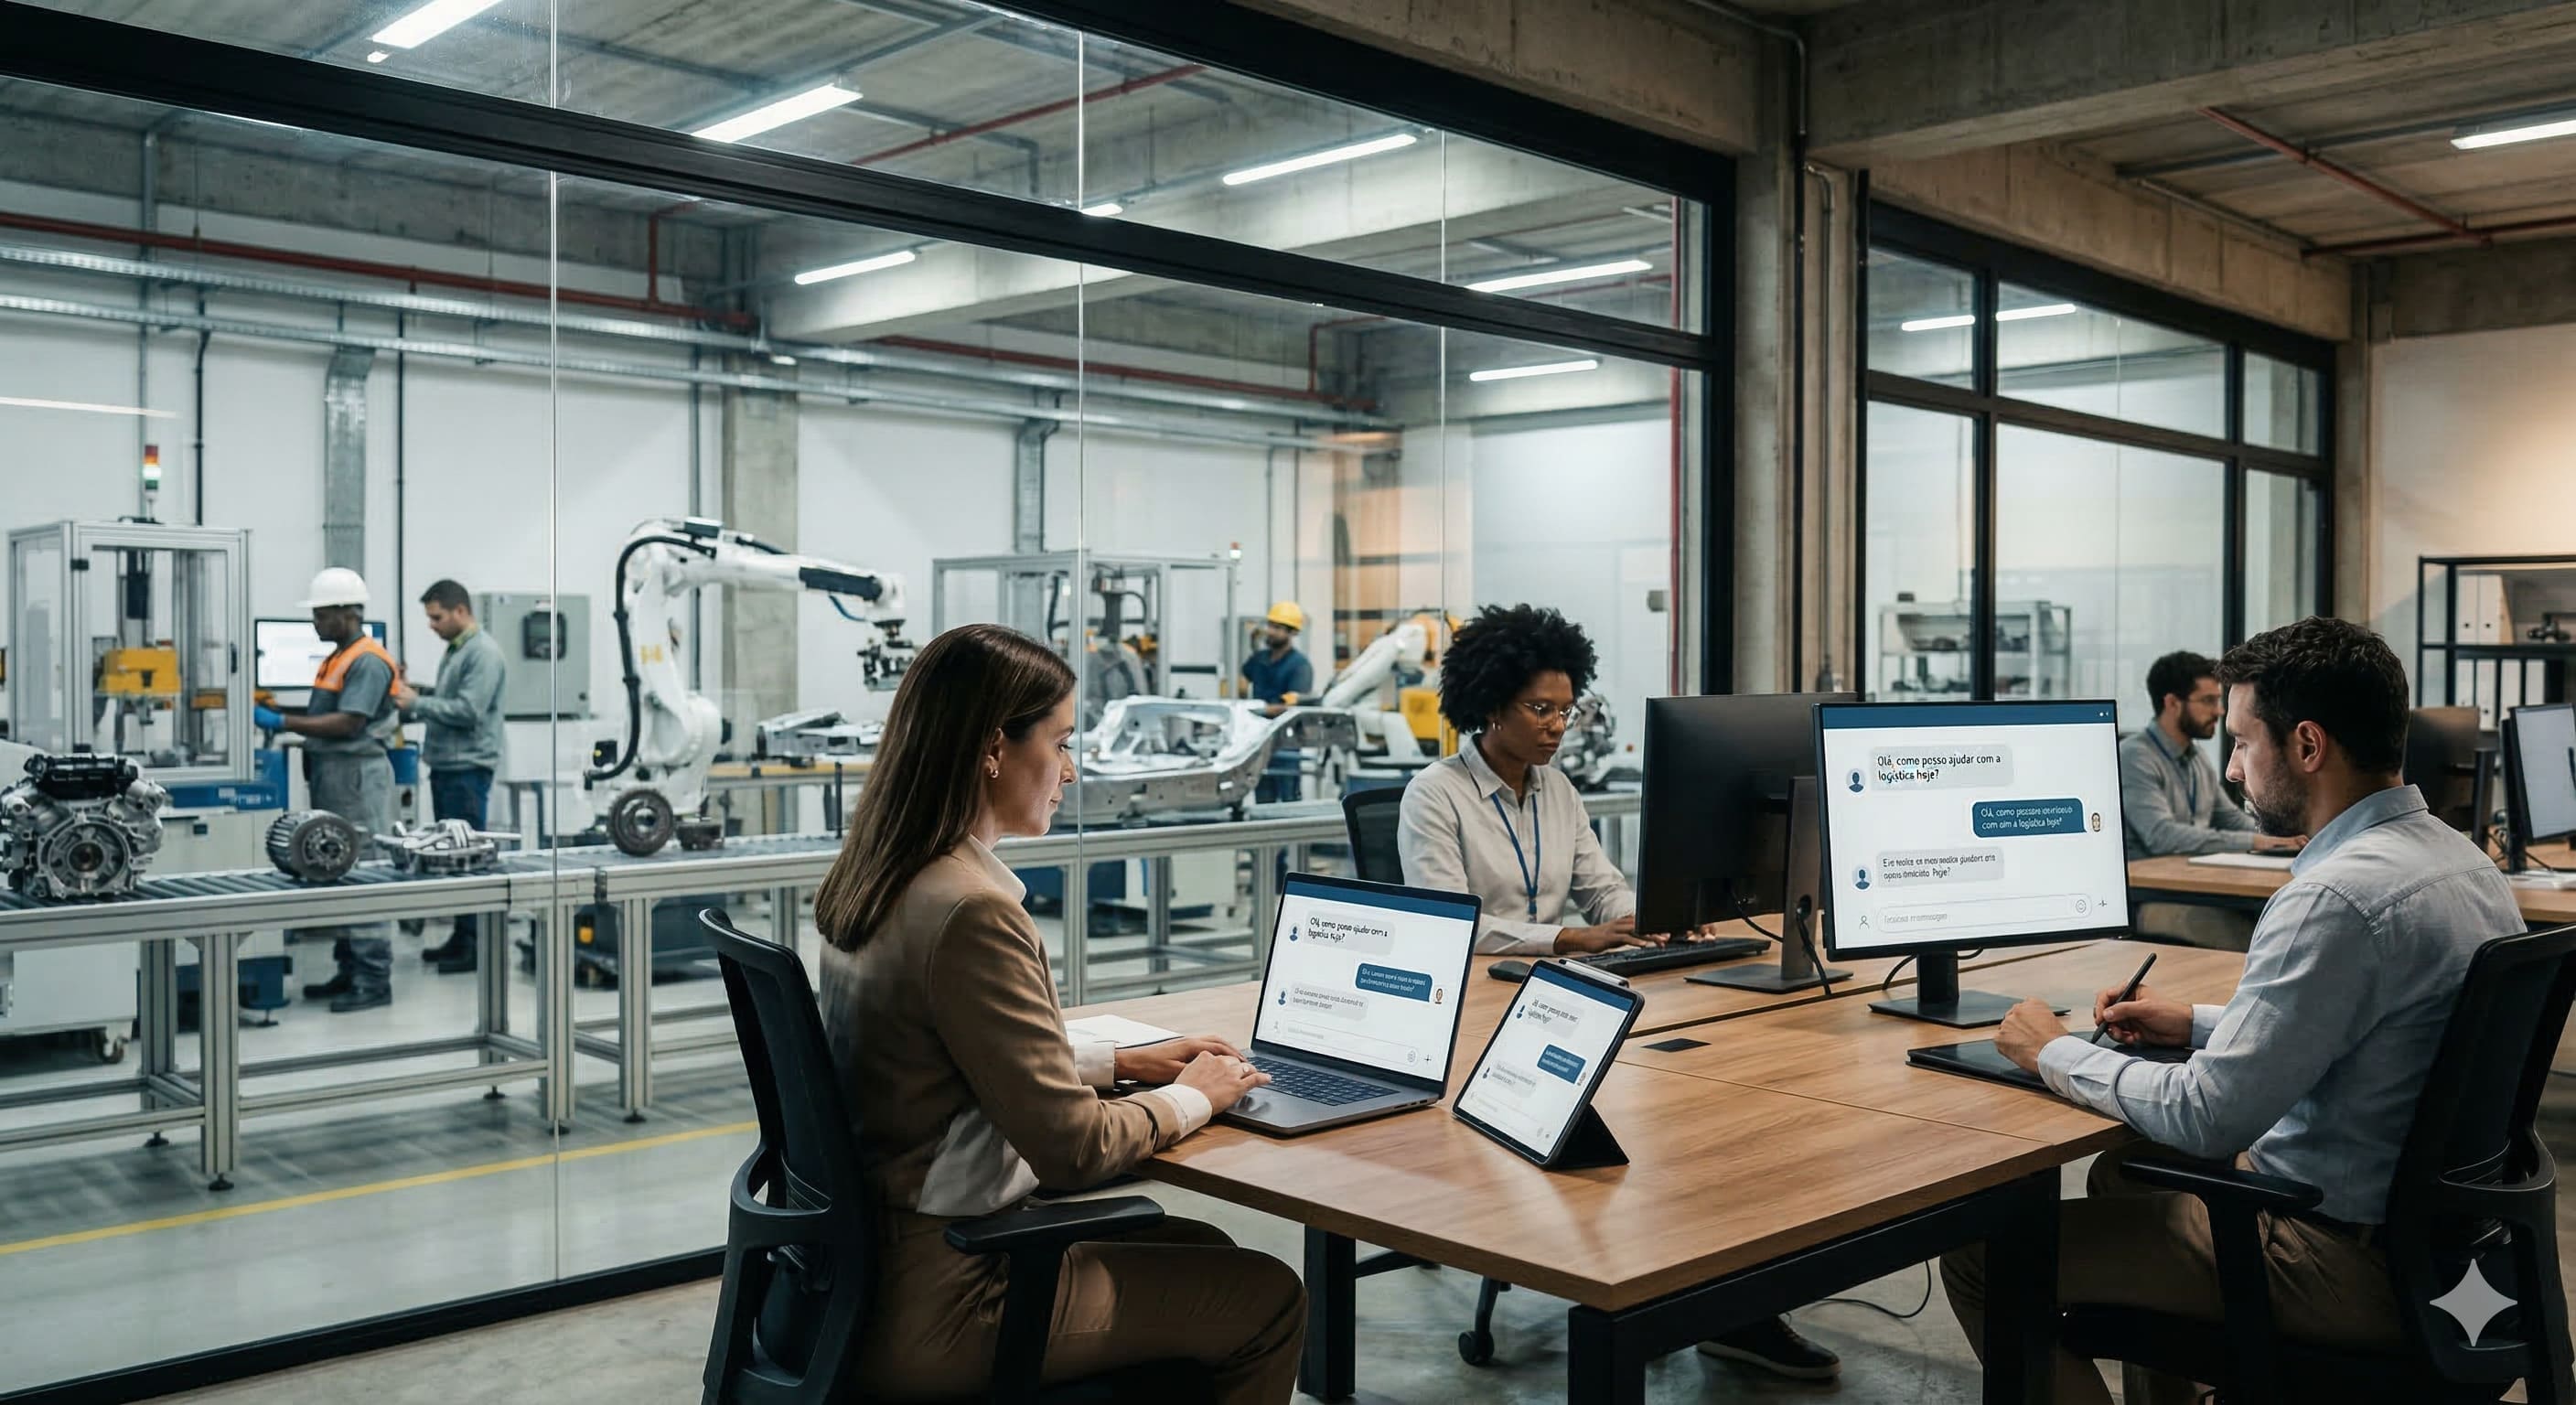
La planificación logística de Master enfrentaba el desafío de la dispersión de información. Los datos de demanda estaban distribuidos en distintos silos, lo que generaba una visión muy macro y agregada de las ventas. Esta falta de granularidad dificultaba la gestión de inventarios y la producción a nivel de SKU, generando exceso de stock en algunos productos y quiebres en otros.
Era necesario “inteligenciar” el proceso para que cada pieza del portafolio tuviera su propia curva de previsión.
versión en español
Centralización de datos y machine learning para la planificación logística granular de miles de SKUs.
Implementación de un modelo de Machine Learning conectado a un Data Lake para predecir ventas mensuales de miles de SKUs individuales, utilizando Model Serving en Databricks para garantizar predicciones en tiempo real.
01. Problema
02. Diagnóstico
DB identificó que la solución no pasaba solo por un nuevo algoritmo, sino por un cambio en la infraestructura de datos. El diagnóstico señaló la centralización en un Data Lake como primer paso para garantizar la integridad de la información.
Además, para manejar la escala de miles de SKUs, el modelo de Machine Learning requería una arquitectura escalable (Databricks) que permitiera no solo predecir, sino también “servir” esas predicciones de forma rápida a los tomadores de decisión.
Además, para manejar la escala de miles de SKUs, el modelo de Machine Learning requería una arquitectura escalable (Databricks) que permitiera no solo predecir, sino también “servir” esas predicciones de forma rápida a los tomadores de decisión.
03. Resolución
Construimos un pipeline de datos end-to-end conectando el Data Lake de Master al modelo predictivo. La solución utilizó un modelo de Machine Learning basado en series temporales, entrenado para identificar patrones de demanda a nivel de SKU.
Para hacer la inteligencia consumible en el día a día, implementamos Model Serving en Databricks, transformando el modelo en un servicio de alta disponibilidad que entrega predicciones en tiempo real. Esto centralizó la visión de la demanda, eliminó discrepancias entre datos dispersos y estableció una base sólida para la planificación logística y de abastecimiento.
Para hacer la inteligencia consumible en el día a día, implementamos Model Serving en Databricks, transformando el modelo en un servicio de alta disponibilidad que entrega predicciones en tiempo real. Esto centralizó la visión de la demanda, eliminó discrepancias entre datos dispersos y estableció una base sólida para la planificación logística y de abastecimiento.
Beneficios obtenidos

Visión granular de la demanda
La transición de una visión agregada a una individual (por SKU) permitió un ajuste fino en la producción y la logística, reduciendo desperdicios y optimizando el inventario.

Centralización de la verdad de los datos
La integración en el Data Lake eliminó la dispersión de información, garantizando que todas las áreas planifiquen la logística con base en los mismos datos validados.

Predicciones en tiempo real con Databricks
El uso de Model Serving aportó una agilidad sin precedentes, permitiendo a Master reaccionar rápidamente a cambios repentinos en la demanda del mercado industrial.

Logística inteligente y ágil
El proceso de planificación se volvió proactivo y basado en datos (data-driven), elevando el nivel de servicio y la resiliencia de la cadena de suministro.